
簡単な答え
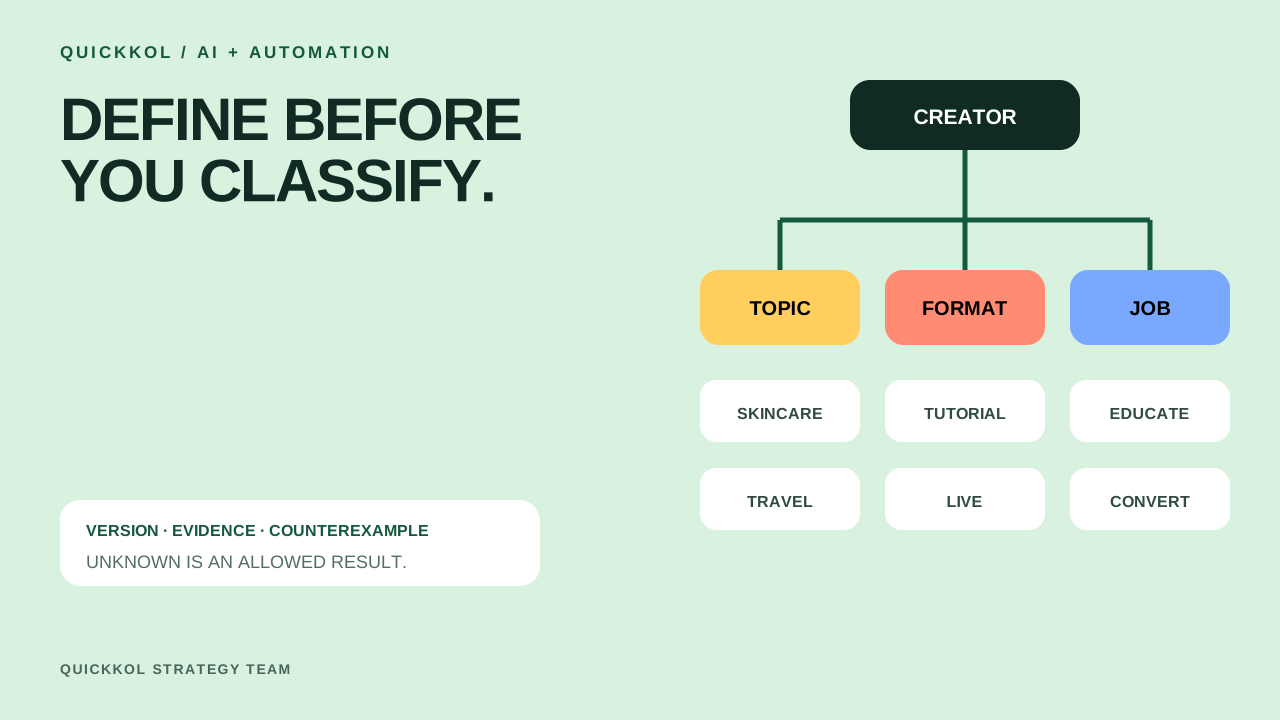
分類体系は、AIのためである前に、事業上の意思決定に役立つものである必要があります。 各分類軸には、名称、定義、含める条件、除外する条件、例、該当しない例、そして「不明」を認める扱いが必要です。主テーマは一つとし、必要に応じて補助タグを付けてください。形式、市場、言語、コンテンツの役割、リスクは分けて管理し、一つのラベルに複数の意味を持たせないようにします。二人がそれぞれ独立して50件のサンプルを分類し、判断の相違を解消してからAIを評価してください。モデルには、推測する代わりに「不明」を返させる必要があります。
実際の検索やレポートで生じる疑問を起点にする
「英国の敏感肌向けチュートリアルを制作するクリエイター」や「素材の利用許諾が可能なB2B解説クリエイター」など、よくある依頼を集めます。それぞれの条件を個別の分類軸に分けます。
タグによって検索、グループ分け、アプローチ、レポートのいずれも変わらないなら、そのタグを維持する価値はないかもしれません。使わない項目を数十個も設けることは避けます。
主カテゴリは重複させず、タグは柔軟に運用する
主テーマはレポート作成の基盤となるため、原則として重複しない分類にします。形式と副テーマは複数選択を認めても構いません。方向性が変わった場合は、履歴を上書きせず、適用開始日を保存してください。
「美容系クリエイター」と「短尺動画クリエイター」は異なる分類軸に属するため、同じ階層で競合させるべきではありません。
各ラベルに当てはまらない例を書く
該当例は含まれるものを示し、非該当例は境界を明らかにします。レビューには包装を開けるだけの開封紹介以上の内容が必要であり、チュートリアルには視聴者が実践できる手順が必要です。
境界が明確になって初めて、一貫性が意味を持ちます。ラベル名だけでは、モデルが一般的な思い込みに基づいて適用範囲を広げてしまいます。
分類の不一致を継続的に測定する
毎月、新規レコードからサンプルを抽出し、AIと人、人同士の判断を比較します。判断の不一致は、定義の不明確さ、コンテンツの不足、モデルの誤り、本質的な曖昧さに分類します。
NIST AI RMFは、継続的なガバナンス、測定、管理を重視しています。検索結果を追跡できるよう、分類体系のバージョンと人による変更をQuickKOLに保存します。
分類体系には、バージョン、定義、反例が必要
AIによる分類は、クリエイターを一つの固定的なラベルに閉じ込めるおそれがあります。コンテンツのテーマ、形式、オーディエンスの課題、商業上の役割、リスクの状態を分けて扱います。各項目に定義、該当例、非該当例、根拠の対象期間、確信度を設定します。NIST AI RMFのGovern、Map、Measure、Manageという構成は、利用状況、測定、継続的なリスク管理を重視しています。同様に、分類体系にも責任者と見直しの周期が必要です。
200アカウントから40件を抽出し、二重にラベル付けします。レビュー担当者が「チュートリアル」のラベル32件で一致し、八件で一致しなかった場合、単純一致率は80%です。自動化の規模を広げる前に、定義と判断が分かれる事例を見直します。テーマに関する根拠の不足をフォロワー数で補ったり、生成されたラベルで人が確認済みの項目を上書きしたりしないでください。
クリエイター分類の階層
各層は一種類の問いに答えます。
| レイヤー | 例 | 根拠の対象期間 |
|---|---|---|
| テーマ | スキンケア、生産性向上、旅行 | 直近の20投稿 |
| フォーマット | チュートリアル、ライブ配信、レビュー | 比較可能なサンプル |
| オーディエンスの課題 | 選び方・使い方 | コメントと検索 |
| 商業上の役割 | 理解促進、コンバージョン、クリエイティブ | パートナーシップ記録 |
チェックリスト
AIによる分類体系を導入する前に
十項目の確認により、分類の根拠を説明でき、継続して管理できる状態を保ちます。
- すべてのラベルに明確な一行の定義がある
- 良い例と悪い例を保存済み
- 複数レーベルと独占条件に関するルールが明確である
- 根拠の対象期間と最低サンプル数が定義されている
- 不明・判定不能も認める
- 少なくとも40件のレコードを二重にラベル付けする
- 判断の不一致をルールの更新に反映する
- モデルの出力で確認済みの事実を上書きできない
- バージョン、担当者、日付が記録されている
- レビュー周期と元に戻す手順が定められている
出典および参考文献
外部ページは変更される可能性があります。公開前にプラットフォームのルール、契約書、および現地法を再確認してください。