总结
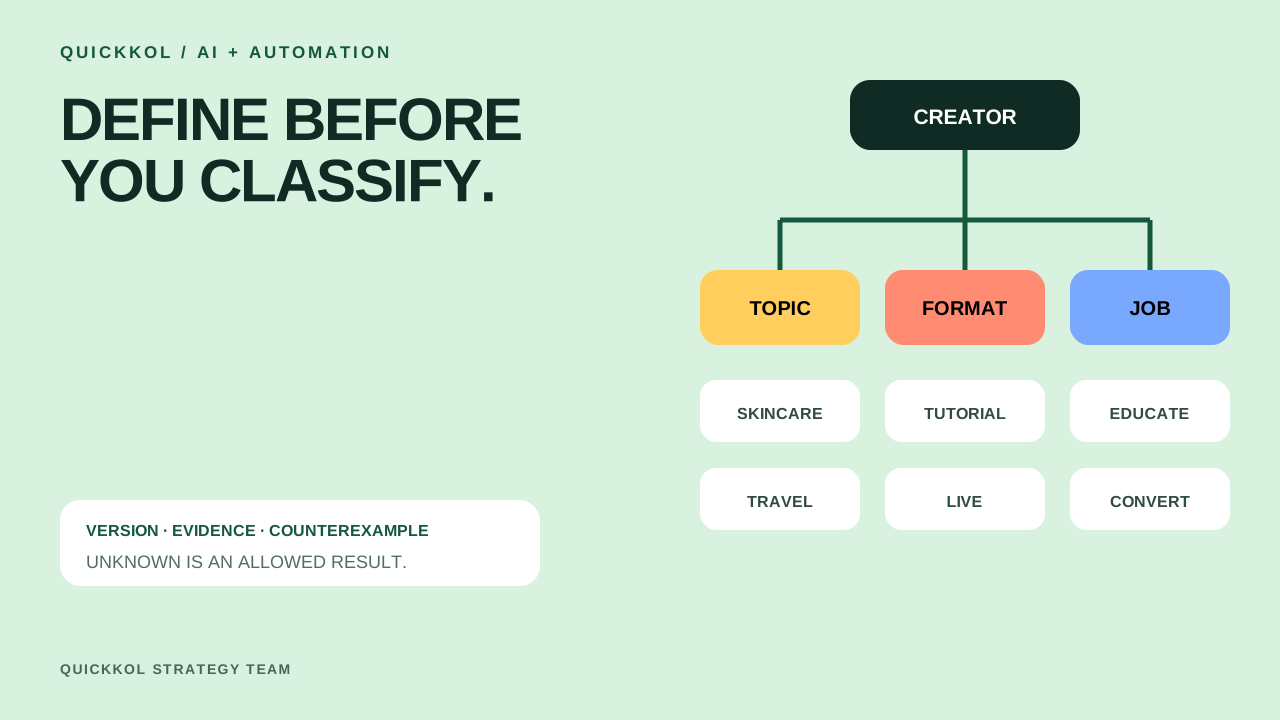
分类体系先服务业务决定,再服务 AI。 每个维度写明名称、定义、包含、排除、正例、反例和允许的未知值。主题使用一个主要类别与若干次级标签;格式、市场、语言、内容任务和风险独立记录,避免一个标签同时表达多件事。先让两位人工对 50 个样本独立分类,修正分歧后再评估 AI;AI 无法判断时必须输出未知,而不是猜测。
从实际搜索和报告问题开始
收集过去 Campaign 中常见需求,例如“英国敏感肌教程型达人”或“可提供授权素材的 B2B 解释者”。把每个条件拆成独立维度。
如果标签无法改变搜索、分组、外联或报告,就不值得维护。避免为了完整建立几十个无人使用的字段。
让主类互斥,标签可以重叠
主要主题用于报表汇总,应尽量互斥;内容形式和次级主题可以多选。达人方向变化时保存生效日期,而不是覆盖历史。
“美妆达人”和“短视频达人”属于不同维度,不能放在同一层级竞争。
为每个标签写反例
正例说明什么属于标签,反例揭示边界。例如“测评”不包括只展示包装的开箱,“教程”需要用户可以跟随的步骤。
边界清楚后,人工和 AI 的一致性才有意义。只给标签名称会让模型用常识自行扩展。
持续测量分类分歧
每月抽样新增记录,比较人工与 AI、人工之间的差异。把分歧归因于定义不清、内容不足、模型错误或真实多义。
NIST AI RMF 强调持续治理、测量和管理风险。QuickKOL 中保存分类版本和人工修改,让搜索结果可以追溯。
分类体系需要版本、定义和反例
AI 分类最容易把一个账号永久固定在一个标签里。更稳妥的做法是把内容主题、内容形式、受众问题、商业任务和风险状态分成不同字段,每个字段保存定义、正例、反例、证据窗口和置信度。NIST AI RMF 的 Govern、Map、Measure、Manage 结构强调持续描述使用场景、测量和管理风险;分类体系也应有负责人和复核周期。
从 200 个账号中抽取 40 个双人标注样本。如果“教程型”有 32 个一致、8 个不一致,简单一致率为 80%。先检查定义和边界样本,再扩展自动分类。不要用总粉丝量补足缺失主题证据,也不要让模型生成的标签覆盖人工确认字段。
达人分类体系层级
每一层只回答一种问题。
| 层级 | 示例 | 证据窗口 |
|---|---|---|
| 主题 | 护肤、效率、旅行 | 20 条近期内容 |
| 形式 | 教程、直播、评测 | 同类样本 |
| 受众问题 | 如何选择 / 如何使用 | 评论与搜索 |
| 商业任务 | 教育、转化、素材 | 合作记录 |
检查清单
AI 分类上线前复核
10 项保证分类可解释和可维护。
- 每个标签有一句清晰定义
- 正例和反例都已保存
- 多标签与互斥规则明确
- 证据窗口与最小样本已定义
- 未知和无法判断可被保留
- 40 个以上样本完成双人标注
- 不一致样本用于修正规则
- 模型输出不会覆盖确认事实
- 版本、负责人和日期已记录
- 复核周期和回滚路径存在
资料来源与延伸阅读
外部页面可能更新;平台规则、合同与当地法规应在 Campaign 启动前再次确认。