
LA RÉPONSE COURTE
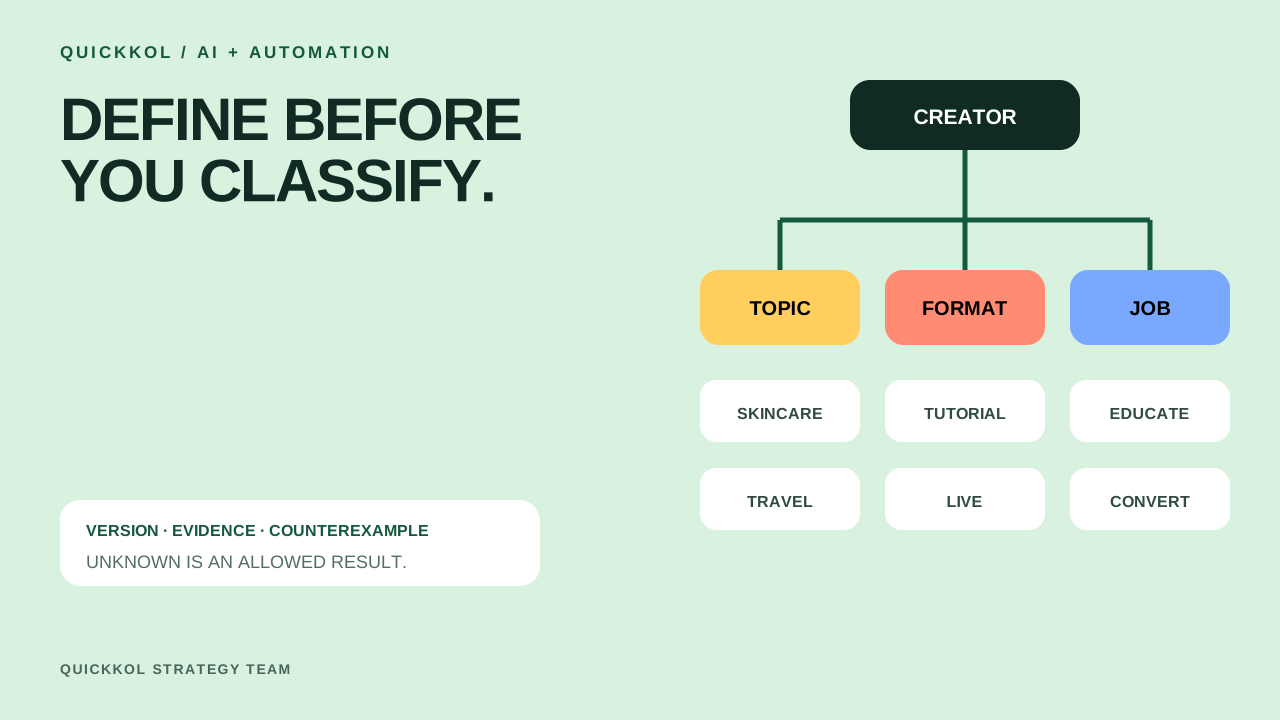
Une taxonomie sert les décisions métier avant de servir l’IA. Chaque dimension doit avoir un nom, une définition, des critères d’inclusion et d’exclusion, des exemples, des contre-exemples et une valeur « inconnu » autorisée. Utilisez un thème principal et des étiquettes secondaires facultatives ; séparez le format, le marché, la langue, la mission du contenu et le risque afin qu’une même étiquette n’exprime pas plusieurs choses. Demandez à deux personnes de classer indépendamment 50 échantillons, résolvez les désaccords, puis évaluez l’IA. Le modèle doit renvoyer « inconnu » plutôt que de deviner.
Partir de questions réelles de recherche et de reporting
Recueillez les demandes courantes telles que « créateurs de tutoriels pour peaux sensibles au Royaume-Uni » ou « spécialistes des contenus explicatifs B2B pouvant accorder des licences sur leurs contenus ». Décomposez chaque condition en dimensions distinctes.
Si une étiquette ne peut pas modifier la recherche, le regroupement, la prise de contact ou le reporting, son maintien n’est peut-être pas utile. Évitez les dizaines de champs inutilisés.
Gardez des catégories principales mutuellement exclusives et des étiquettes souples
Les thèmes principaux servent au reporting et doivent être largement exclusifs les uns des autres ; les formats et les thèmes secondaires peuvent autoriser plusieurs sélections. Lorsque l’orientation change, enregistrez la date d’effet au lieu d’écraser l’historique.
« Créateur beauté » et « créateur de formats courts » relèvent de dimensions différentes et ne doivent pas se concurrencer au sein d’une même hiérarchie.
Rédigez des contre-exemples pour chaque libellé
Les exemples montrent ce qui est inclus ; les contre-exemples révèlent les limites. Un avis va au-delà d’un déballage limité à l’emballage, et un tutoriel doit présenter des étapes que le spectateur peut suivre.
La cohérence ne prend son sens que lorsque les limites sont claires. Les seuls noms d’étiquettes incitent le modèle à élargir leur portée à partir d’hypothèses générales.
Mesurez en continu les désaccords de classification
Chaque mois, échantillonnez les nouvelles fiches et comparez les évaluations de l’IA à celles des personnes, puis les évaluations humaines entre elles. Classez les désaccords selon leur cause : définition imprécise, contenu insuffisant, erreur du modèle ou ambiguïté réelle.
Le NIST AI RMF souligne l’importance d’une gouvernance, d’une mesure et d’une gestion continues. Enregistrez la version de la taxonomie et les modifications humaines dans QuickKOL pour assurer la traçabilité des résultats de recherche.
Une taxonomie nécessite des versions, des définitions et des contre-exemples
La classification par l’IA peut enfermer un créateur dans une étiquette permanente. Distinguez le sujet du contenu, le format, le problème de l’audience, le rôle commercial et le statut de risque. Pour chaque champ, indiquez une définition, un exemple positif, un contre-exemple, une période d’observation et un niveau de confiance. La structure Govern, Map, Measure et Manage du NIST AI RMF met l’accent sur le contexte d’utilisation, la mesure et la gestion continue des risques ; la taxonomie doit elle aussi avoir un responsable et un cycle de révision.
Faites attribuer des étiquettes à un échantillon de 40 comptes sur 200 par deux évaluateurs. Si les évaluateurs s’accordent sur 32 étiquettes « tutoriel » et divergent sur huit, le taux d’accord simple est de 80%. Réexaminez les définitions et les cas limites avant de déployer l’automatisation à grande échelle. Ne remplacez pas les preuves thématiques manquantes par le nombre d’abonnés et ne laissez pas les étiquettes générées écraser les champs confirmés par une personne.
Niveaux de la taxonomie des créateurs
Chaque niveau répond à un type de question.
| Couche | Exemple | Période de collecte des éléments probants |
|---|---|---|
| Sujet | Soins de la peau, productivité, voyage | 20 publications récentes |
| Format | Tutoriel, direct, avis | Échantillon comparable |
| Problème rencontré par l’audience | Comment choisir / utiliser | Commentaires et recherche |
| Fonction commerciale | Pédagogie, conversion, création | Fiche de partenariat |
LISTE DE CONTRÔLE
Avant de déployer une taxonomie fondée sur l’IA
Dix vérifications permettent de conserver une classification explicable et facile à maintenir.
- Chaque étiquette possède une définition claire en une ligne
- Les exemples positifs et négatifs sont enregistrés
- Les règles d’étiquetage multiple et d’exclusivité sont claires
- La période de collecte des éléments probants et l’échantillon minimal sont définis
- Les valeurs « inconnu » et « indéterminé » sont autorisées
- Au moins 40 fiches font l’objet d’un double étiquetage
- Les désaccords permettent d’actualiser les règles
- Les résultats du modèle ne peuvent pas écraser les faits confirmés
- La version, le responsable et la date sont consignés
- Un cycle de révision et une procédure de retour en arrière sont définis
Sources et lectures complémentaires
Les pages externes peuvent changer. Vérifiez à nouveau les règles de la plateforme, les contrats et la législation locale avant de lancer.