总结
假粉检测工具应当提供可复核的风险线索,而不是替品牌宣布某位达人作弊。 采购时用已知案例和边界情况测试平台覆盖、缺失处理、误报与解释能力。没有可靠真实标签,就不能声称测出了准确率;可先验收系统是否能支持审慎的人工决策。
先定义工具要帮助哪个决策
把任务限定为联系前筛查、合同前复核或已上线异常调查。不同阶段需要不同证据强度。一次自动标记可以触发研究,不应直接触发公开指控或拒付已完成工作。
受众质量指南可帮助区分内容适配与数据风险。工具应补充作品和商业条件核验,而不是因为一个分数就覆盖全部判断。
核实平台与指标的实际覆盖
Modash 的官方资料将其假粉与可信度估算限定在 Instagram。不要因为同一产品也能搜索 TikTok 或 YouTube,就推断这些平台有同样的风险指标。每个字段都应记录平台、来源和更新时间。
供应商没有数据时,预期输出应是不可用,不是安全。把覆盖率、可解释性和风险估算分别验收,避免缺失账号被自动放行。
建立案例集,不假装拥有真相
案例集可以包含真实标注充分的记录、明确未知的记录,以及用于检查数据流程的合成记录。合成的粉丝增长曲线不能被当成真实作弊证据,也不能证明模型在市场中的表现。
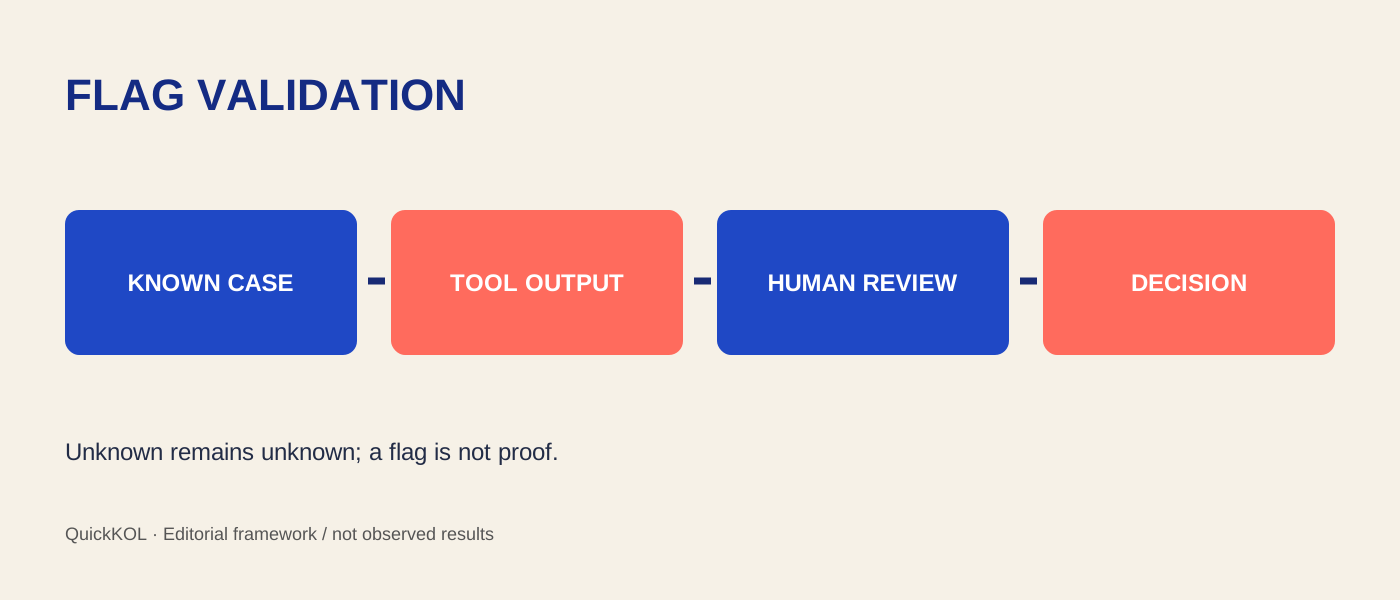
对每个标签写出依据、标注人和争议。若只有人工印象,就叫人工判断,不叫地面真值。缺少可信标签时,聚焦可用性与解释测试。
分别检查误报、漏报与未知
误报是把真实但异常的情况判为风险,漏报是未发现已有充分依据的问题。只有参考标签可靠时,才能计算相关比例。另设未知类别,不把它并入通过或失败。
重点检查自然爆款、长期停更后恢复、账号改名和受众地区变化等边界。它们本身不证明真假,作用是观察工具能否解释信号,而不是机械给出结论。
算例:精确率不是覆盖率
假设二十个有可靠标签的测试案例中,工具标记五个,其中三个为参考问题案例,两个为误报。标记中的正确比例为 3/5,即 60%。还需要知道总共有多少问题案例,才能讨论召回。
这是教学假设,不是任何产品测试结果。另有十个未取得数据的案例,应报告未覆盖,而不能因为没有标记而算作正确。
风险解释必须能进入人工复核
要求导出触发线索、原始观察时间、模型版本和限制说明。复核人员应能够联系创作者询问与项目有关的解释,而不是让对方证明自己整个人“真实”。
不索取密码,不公开传播未核实标签。对补充证据保留版本,说明结论为何改变。公平复核备忘录可帮助把事实、解释和商业决策分开。
把验收结果变成使用规则
最后决定哪些情况可自动进入普通研究,哪些必须人工复核,哪些因缺失暂缓。规则应包括负责人、证据要求和复查时间。不要把供应商默认阈值当行业标准。
结合受众质量指南和复核备忘录,保留完整案例集与限制。QuickKOL 可用于研究达人内容与准备联系,风险工具的独立结论仍需要按来源复核。
没有真实标签还能采购吗?
可以比较覆盖、解释、导出和复核工作量,但应承认没有测得检测准确率。先以辅助研究工具试用,限制自动决策权限,并保留出现争议时的人工判断路径。
研究依据、日期与边界
资料核验于 2026-10-23。流程为编辑建议;所有算例均为假设,不是客户结果、达人排名或报价。
本次任务的决策表
以下为编辑分析或明确标注的假设算例,不是表现排名、报价或效果保证。
| 条件 | 证据 | 决策 |
|---|---|---|
| 有标签案例 | 可追溯的参考依据 | 才讨论误报漏报 |
| 未知案例 | 标签或数据不足 | 不强制归为通过 |
| 工具信号 | 时间、模型与解释 | 进入人工复核 |
检查清单
开始执行前确认
把以下答案写入本次项目记录。
- 核对每个平台覆盖
- 未知不等于安全
- 合成案例不是市场结果
- 结论可以被修正
资料来源与延伸阅读
外部页面可能更新;平台规则、合同与当地法规应在 Campaign 启动前再次确认。