总结
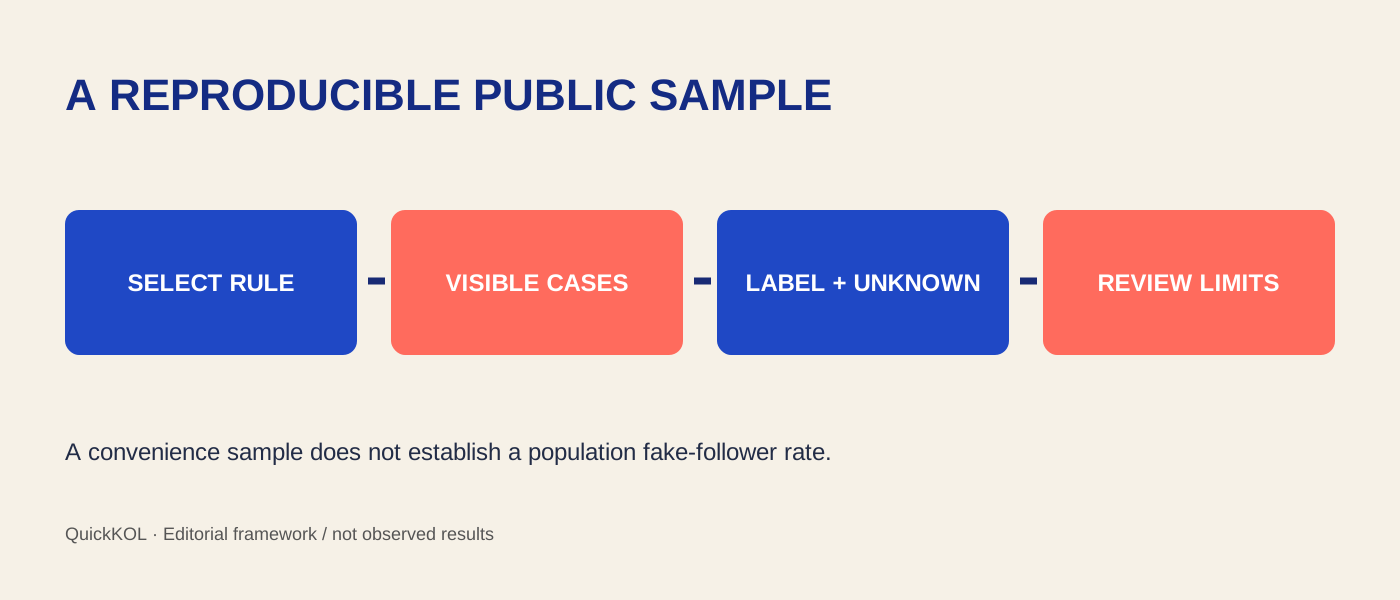
公开抽样可以帮助发现需要调查的模式,但必须说明如何取得样本。 按页面显示顺序选择并不自动构成随机抽样。记录入口、时间、位置与未知分类,将结论限制在实际看过的记录;没有合理抽样框,就不要给全体粉丝计算貌似精确的真假比例。
先确定公开检查能取得什么
记录能看到的是粉丝列表、评论者还是工具导出的子集。它们对应不同群体,不能因为都出现在账号附近就混用。访问受限时不要绕过权限。
粉丝检查指南提供基础字段。先确认账号身份和读取时间,再保存样本范围。若只能检查一小部分,报告应明确覆盖限制,而不是暗示看过所有人。
写出选择规则并保持不变
在研究前固定入口和选取方式,例如记录某时点某个可见列表的指定位置。这样可以解释过程,但除非选择概率已知,仍只能称为便利或系统选取。
不要看到可疑账号后才扩大它附近的样本,再把这些记录与原样本一起计算。调查扩展可以保留,但应单独标记,避免选择偏差被隐藏。
分类先描述事实再作判断
设置少量可观察字段,例如是否有公开作品、是否存在明显重复文本,以及哪些信息无法读取。它们不是自动判假规则。对不熟悉语言或无法解释的记录保留未知。
Modash 的方法文档描述其网络信号模型;手工公开检查无法复制该模型。不要把几个目测特征称为同等检测技术,也不使用供应商阈值认证自己的样本。
算例:未知如何改变样本比例
假设四十个已检查记录中,十二个按本次规则被标记,二十个未标记,八个未知。已标记占所查样本 30%;若未知全部也满足标记条件,算术上界为 50%。
这不是置信区间,也不是全体粉丝假粉率,只是未知分类的两种处理。不要把 30%–50% 写成检测准确率,或据此推断谁购买了粉丝。
让第二位复核者看到相同证据
选一部分记录让第二位同事独立判断,比较分歧原因。若一人把无头像判异常、另一人保留未知,就先统一规则,不急着求平均分。
保留匿名标识和必要来源,避免在广泛报告中传播普通用户个人资料。复核目的在于改善分类一致性,不是声称人工意见已经成为真实身份标签。
把发现用于下一步,而非直接定罪
若发现持续模式,说明需要什么补证:工具字段解释、某段变化背景或有日期的受众汇总。问题应具体,不让创作者对整个互联网行为负责。
公平复核指南可连接观察与采购决定。对自然分发要求高的任务,可以暂缓关键条件;对素材制作,则按实际范围判断。不要将探索性抽样自动升级为公开结论。
保存一份可以重做的抽样记录
最终文件保留账号、时间、入口、规则版本、记录数、分类与未知处理、复核分歧及下一步。再次检查时产生新版本,不覆盖原始观察。
结合粉丝检查指南与复核指南,让过程可解释。QuickKOL 可帮助整理研究和准备联系,公开抽样的覆盖限制不会因进入工具而消失,结果仍应按实际观察范围表述。
两位审阅者标签不同怎么办?
先比较各自依据和可见内容,不用资历或多数票代替证据。可以保留分歧状态,修订标签定义后重新处理受影响案例。不要只改最后总数而不保留原标签和原因,否则无法知道比例变化来自新证据还是规则变化。
增加样本就一定解决偏差吗?
不一定。若入口只展示特定排序,更多记录仍可能来自同样偏差。先理解取得方式,再决定是否扩大。数量可以减少某些随机波动,但不能自动修复不完整的抽样框。
研究依据、日期与边界
资料核验于 2026-10-23。工作流程为编辑建议,数值算例均为假设,不是客户表现、报价或排名。
执行比较表
以下为编辑分析或明确标注的假设算例,不是表现排名、报价或效果保证。
| 任务 | 依据 | 处理 |
|---|---|---|
| 原样本 | 固定入口与位置规则 | 记录实际覆盖 |
| 分类 | 12 标记、20 未标记、8 未知,假设 | 未知不强行补齐 |
| 扩展调查 | 因发现而追加的记录 | 与原样本分开 |
检查清单
开始执行前确认
把以下答案写入本次项目记录。
- 先写选取规则
- 评论者不等于粉丝
- 区间不是置信区间
- 保留复核分歧
资料来源与延伸阅读
外部页面可能更新;平台规则、合同与当地法规应在 Campaign 启动前再次确认。