总结
评论分析需要先定义样本和分类。 每位达人从至少 3–5 条同类内容中抽取 50–100 条可见评论,记录置顶、回复、时间和是否来自抽奖。把评论编码为产品问题、使用体验、购买或行动、反对意见、社区互动和低信息反应。购买意图只能从明确表达中识别,不能把“喜欢”“需要”或表情自动计算为订单意向。
设计能够重复的抽样方法
可以按最新评论、最高赞和随机位置各抽一部分,避免只看品牌最想看到的评论。删除垃圾、重复和无语言信息,但记录剔除数量。
不同平台排序逻辑不同,结果只能用于比较相近平台与格式。抽样日期和内容链接必须保存。
建立互斥的主要编码
每条评论选择一个主要类别,再允许一个次要标签,例如“询问价格”主要属于产品问题,次要可标购买意图。这样总数不会因多标签超过样本量。
先用 20 条评论让两位审核者独立编码,比较分歧并修正定义,再处理完整样本。
区分明确行动和模糊热情
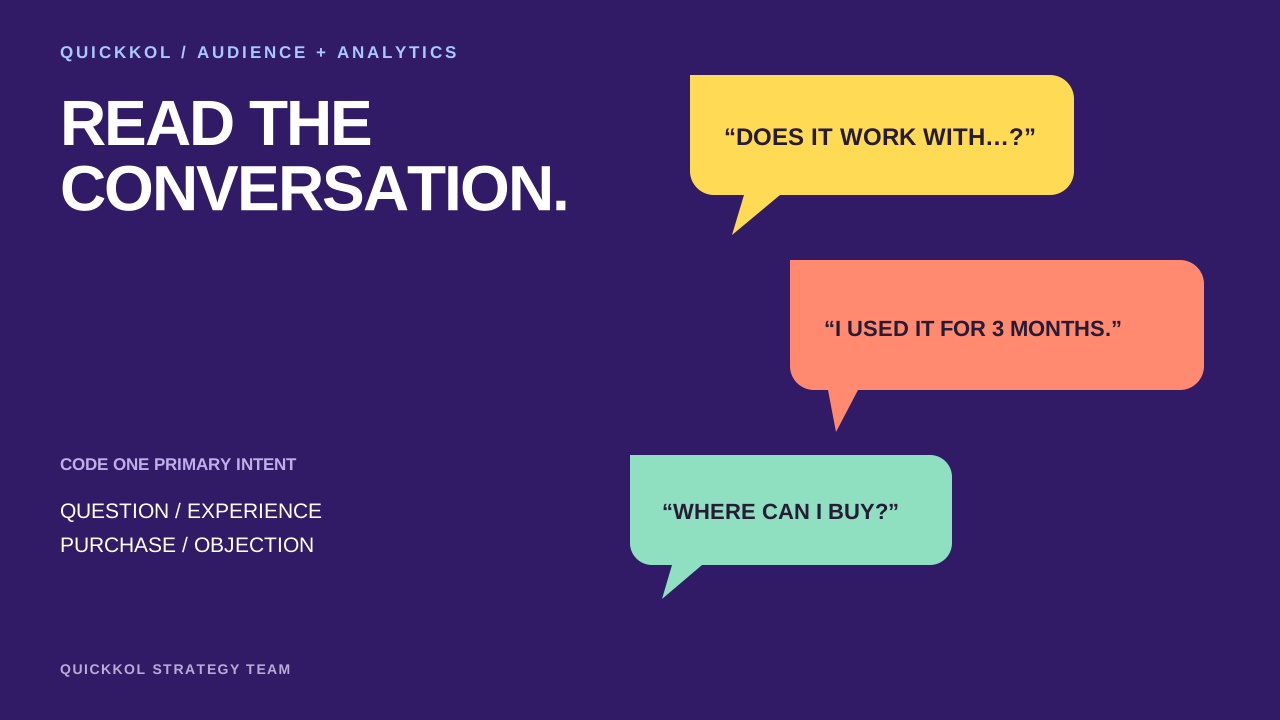
“已下单”“链接在哪里”“能寄到德国吗”比“太喜欢了”提供更多决策信息。报告应展示各类数量、占比和代表例句,而不是一个不透明的意图分数。
评论可能受置顶、创作者回复和活动机制影响。把这些背景作为列保存,避免把运营动作当成自然需求。
把评论洞察送回内容与产品团队
高频问题可以进入下一版 Brief,反对意见可以交给产品或客服验证,真实使用语言可以帮助外联和落地页。未经同意不要展示个人身份信息。
QuickKOL 中只保存必要的匿名摘要、原始链接和编码规则。评论洞察用于提出更好的问题,不用于识别或画像个体用户。
抽样评论时同时保留分母和语境
FTC 的虚假社交指标规则提醒品牌,评论也可能被用于表达影响力,因此不能把评论数量直接当成受众兴趣。建议从同类内容中抽取至少 100 条非置顶评论,记录问题、经验、购买意图、异议、低信息互动、重复文本和疑似无关流量。
例如 120 条样本中有 28 条具体问题、22 条真实经验、14 条购买意图、18 条异议、30 条低信息互动、8 条重复或无关文本。高信息评论为 64 条,占 53.3%;这个比例只能描述本次样本,不能推断全部粉丝。最好由第二位审核者复查 20 条,比较分类一致性。
评论样本编码表
每条只标一个主要意图,保留原文链接。
| 类别 | 判定线索 | 可支持的判断 |
|---|---|---|
| 问题 | 请求具体信息 | 信息需求 |
| 经验 | 描述使用或比较 | 场景相关性 |
| 购买意图 | 价格、渠道、库存 | 行动兴趣 |
| 低信息 / 无关 | 表情、重复、跑题 | 不支持质量结论 |
检查清单
评论质量抽样流程
8 步建立可复核的评论样本。
- 选取 5–10 条同类内容
- 排除置顶与创作者自评
- 保留至少 100 条随机样本
- 每条只编码一个主要意图
- 记录语言、日期与内容链接
- 分开低信息与可疑重复
- 由第二人复查 20 条
- 报告样本数和限制
资料来源与延伸阅读
外部页面可能更新;平台规则、合同与当地法规应在 Campaign 启动前再次确认。